Originality.ai marcó como probablemente generado por IA un artículo sobre resolución de problemas que escribí a partir de mis propias notas. El borrador tenía 743 palabras y lo pegué después de eliminar los pies de las capturas de pantalla. Para quienes hayan evaluado Originality.ai, ¿cómo comprueban si un resultado como este constituye una prueba útil y no un falso positivo? Tengo el historial de revisiones, pero intento entender qué se puede demostrar razonablemente con el resultado de la detección antes de hablarlo con mi editor.
La confianza no equivale a exactitud
El error consiste en tratar el porcentaje de confianza de un detector como prueba de que suele acertar. Vi una y otra vez por qué ese cálculo falla: la confianza, la probabilidad y la proporción estimada de contenido generado por IA describen cosas distintas. Los decimales no aportan las pruebas que faltan.
Empieza por las respuestas incorrectas
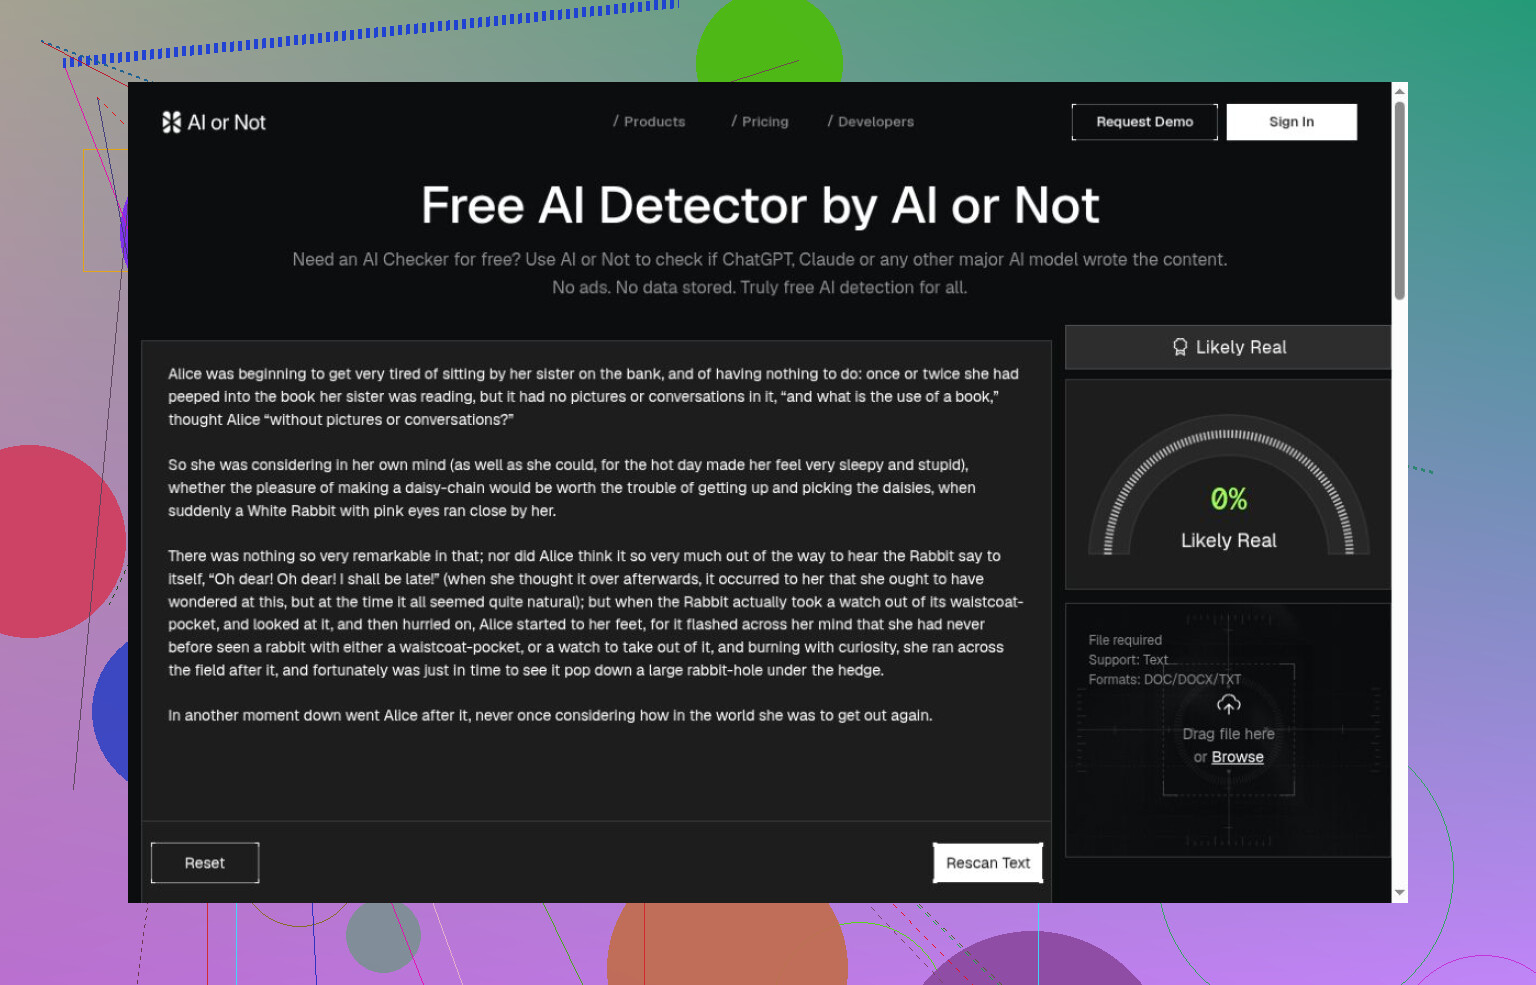
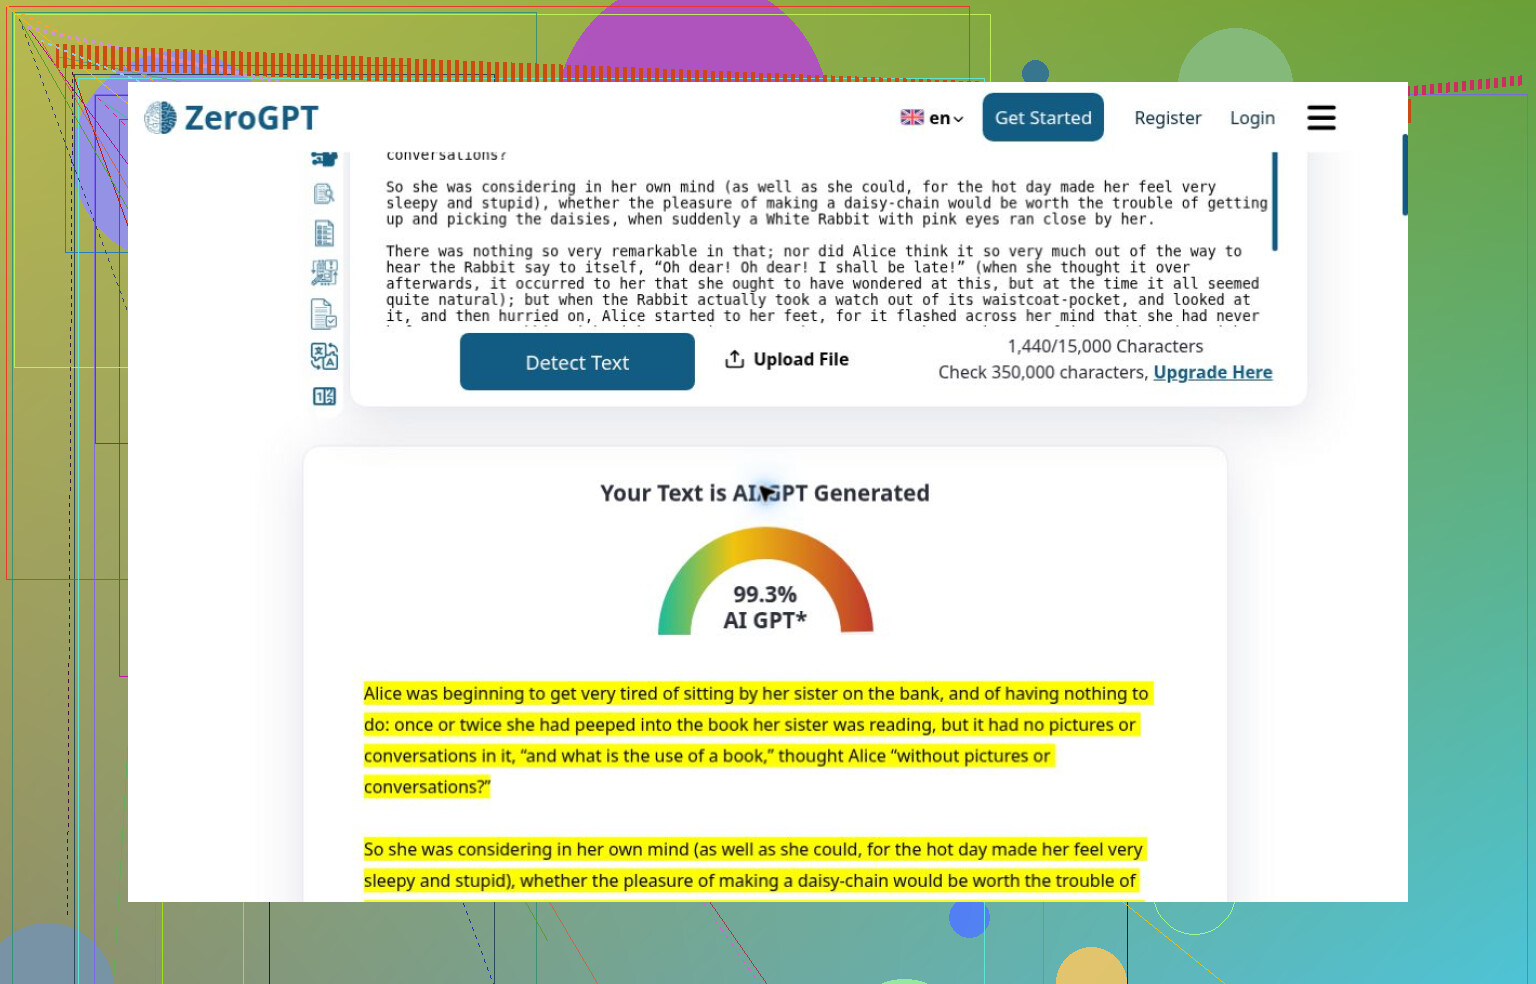
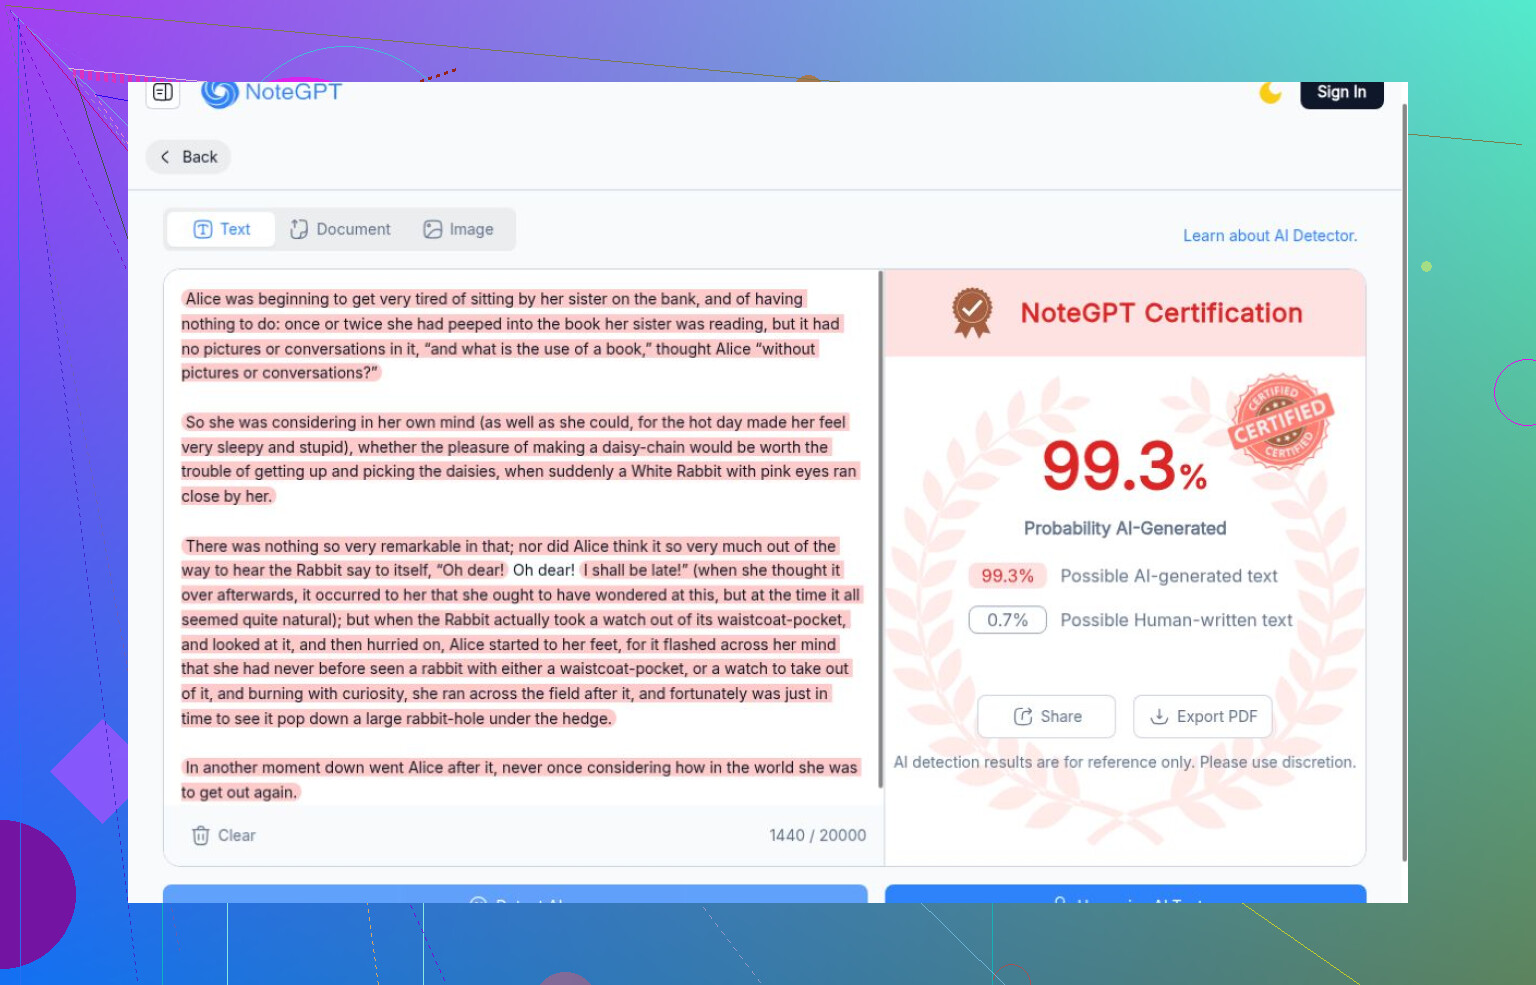
ZeroGPT detectó los pasajes generados, pero clasificó el texto de Lewis Carroll como un 99,3 % de IA, por encima de todas las muestras generadas. NoteGPT también asignó su puntuación de IA más alta al fragmento escrito por una persona.
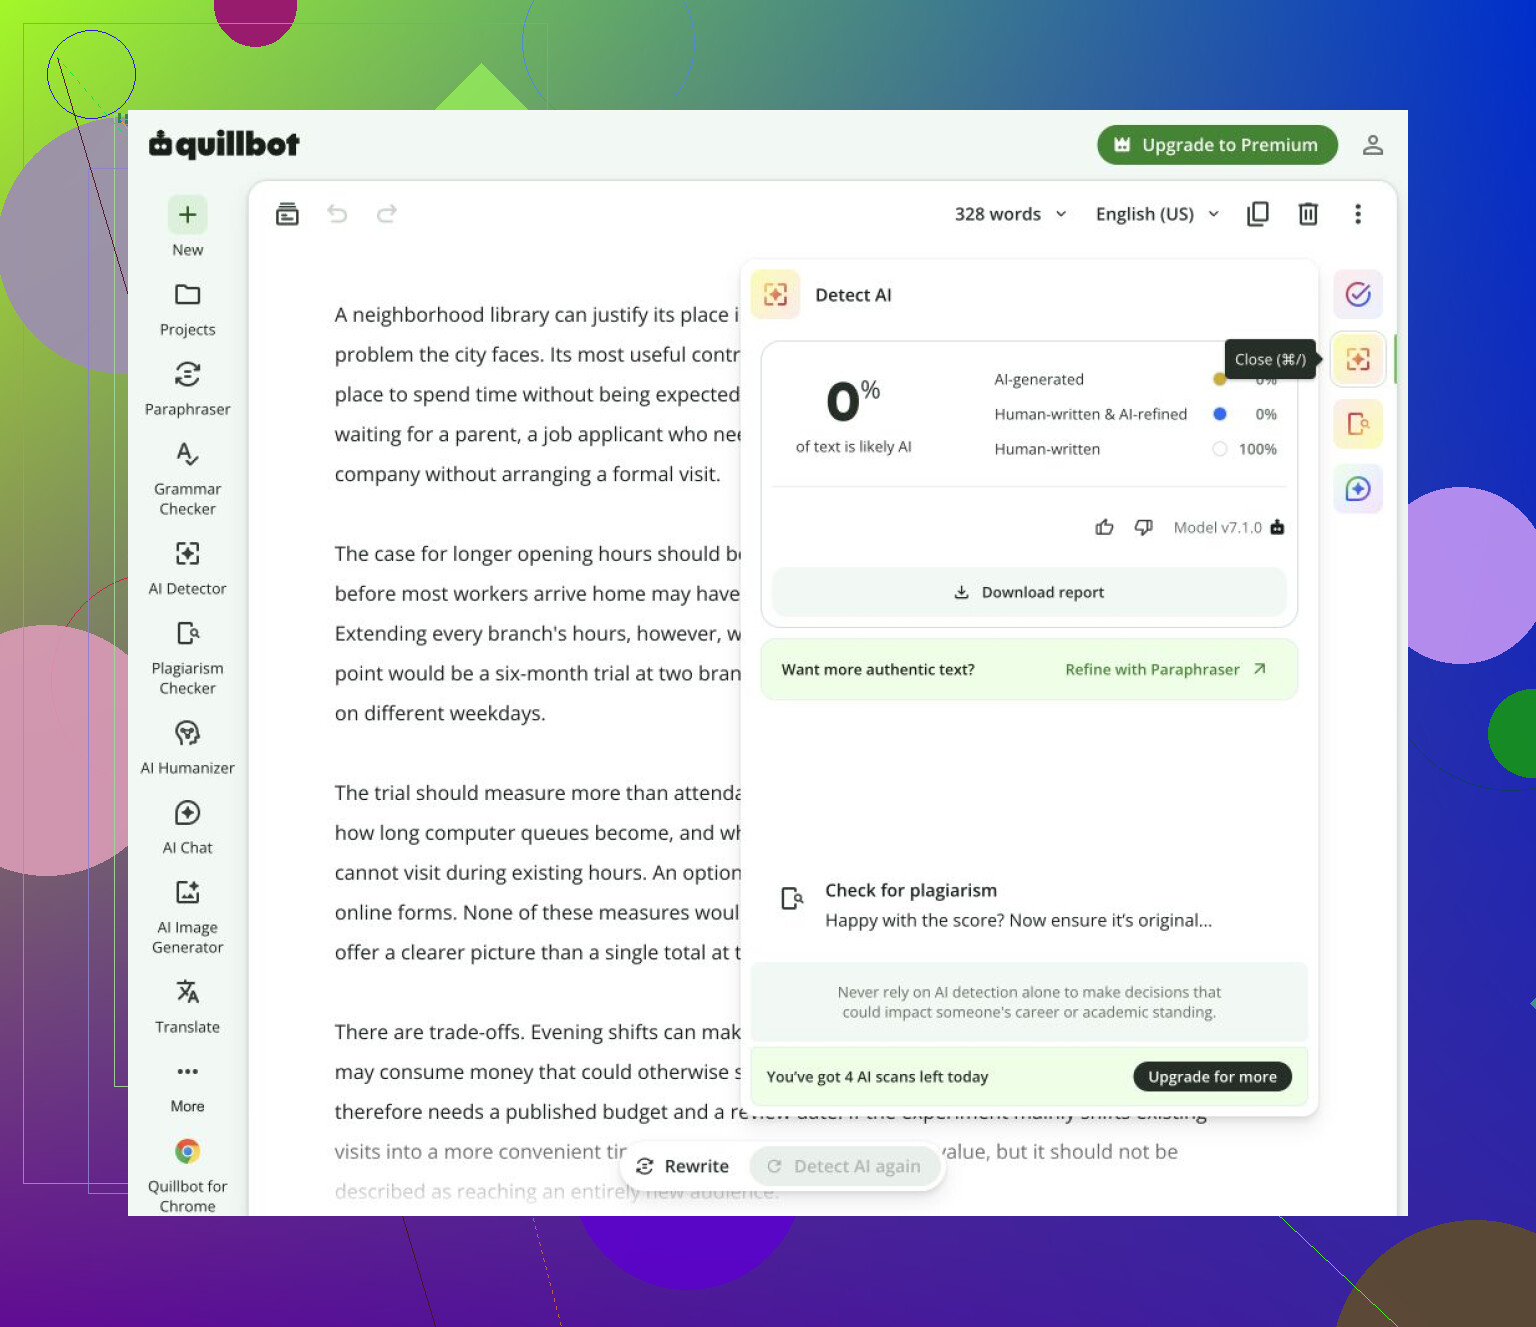
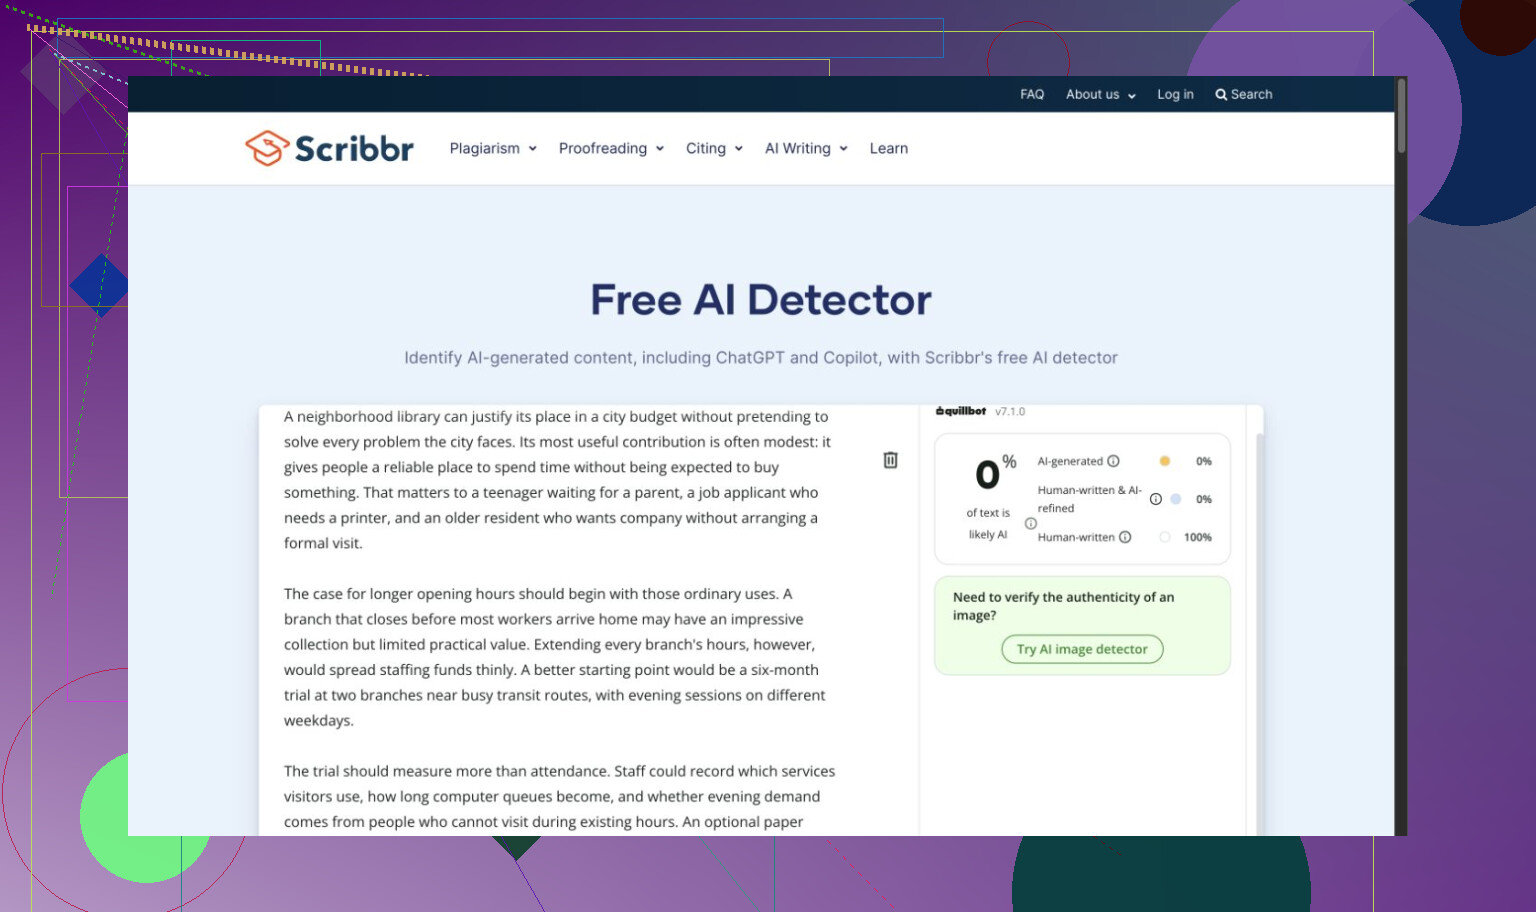
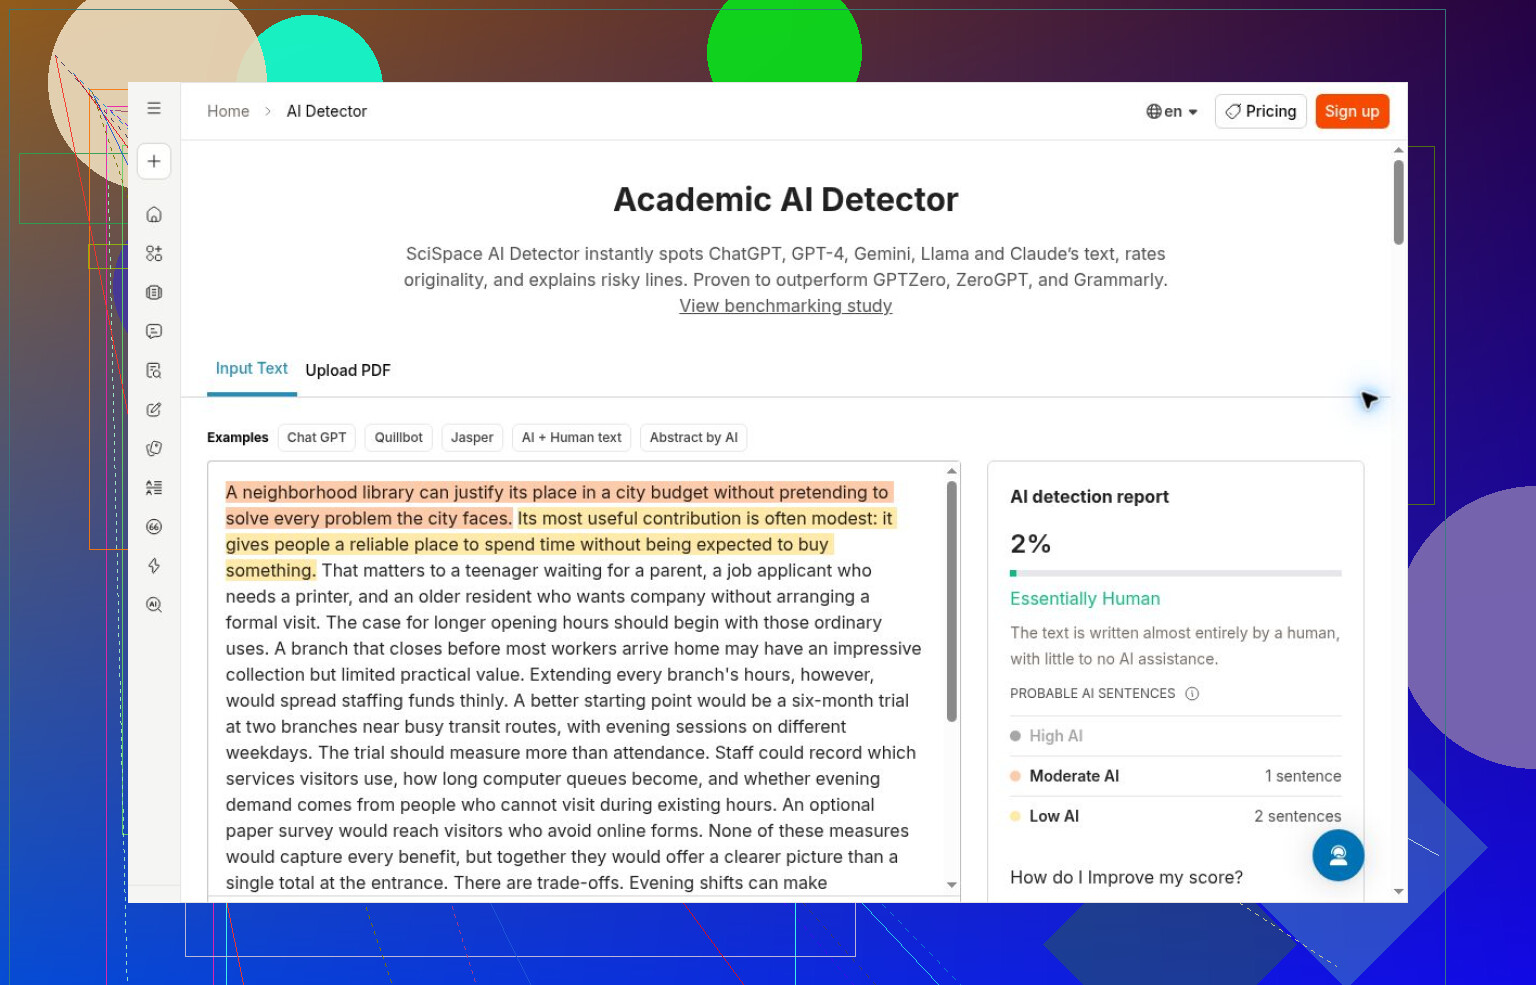
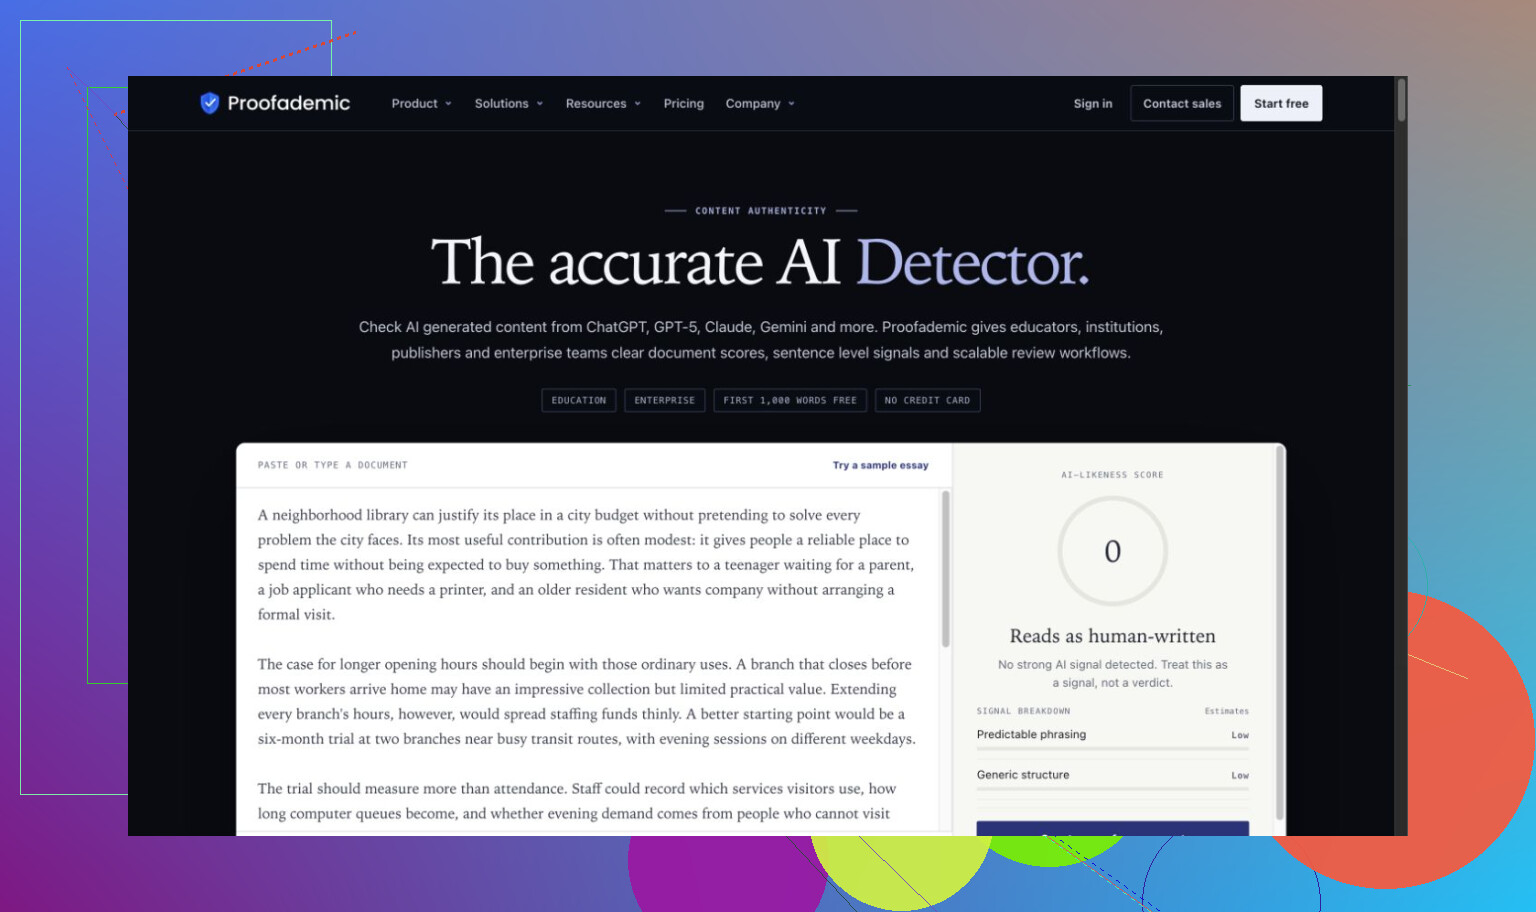
El fallo opuesto también fue importante. QuillBot aceptó los cuatro pasajes generados como humanos. Scribbr no detectó el ensayo, y la presencia visible de la marca QuillBot me hizo dudar a la hora de contarlo como un voto independiente. SciSpace, la demo pública de Proofademic y Surfer tampoco detectaron textos generados.
Mantén el denominador a la vista
Reutilicé seis pasajes en inglés sin modificarlos: textos generados en varios formatos, un fragmento de Carroll y ese mismo fragmento ligeramente editado por IA. Algunas muestras estaban relacionadas. Fue una comparación pequeña, no un estudio representativo de exactitud.
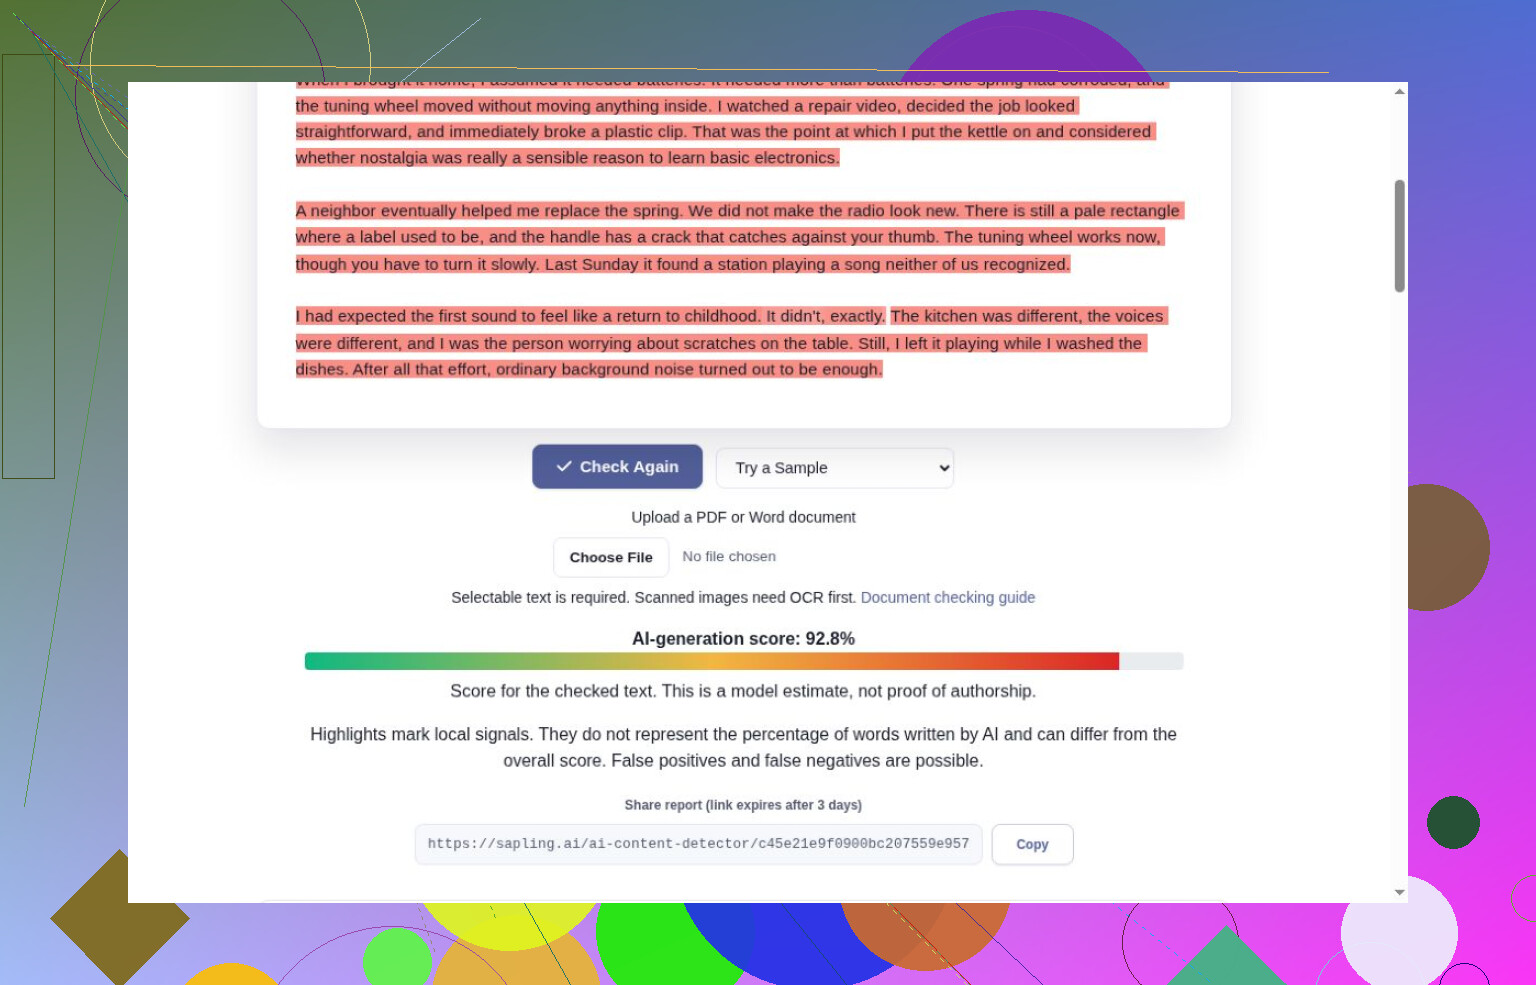
Los intentos sin completar quedaron fuera de los resultados. Sapling solo analizó una parte del ensayo; GPTZero dejó visible una puntuación anterior después de que yo sustituyera el texto. Ninguno de estos detalles debería quedar disimulado bajo la etiqueta de «análisis realizado con éxito».
El acceso forma parte de la utilidad
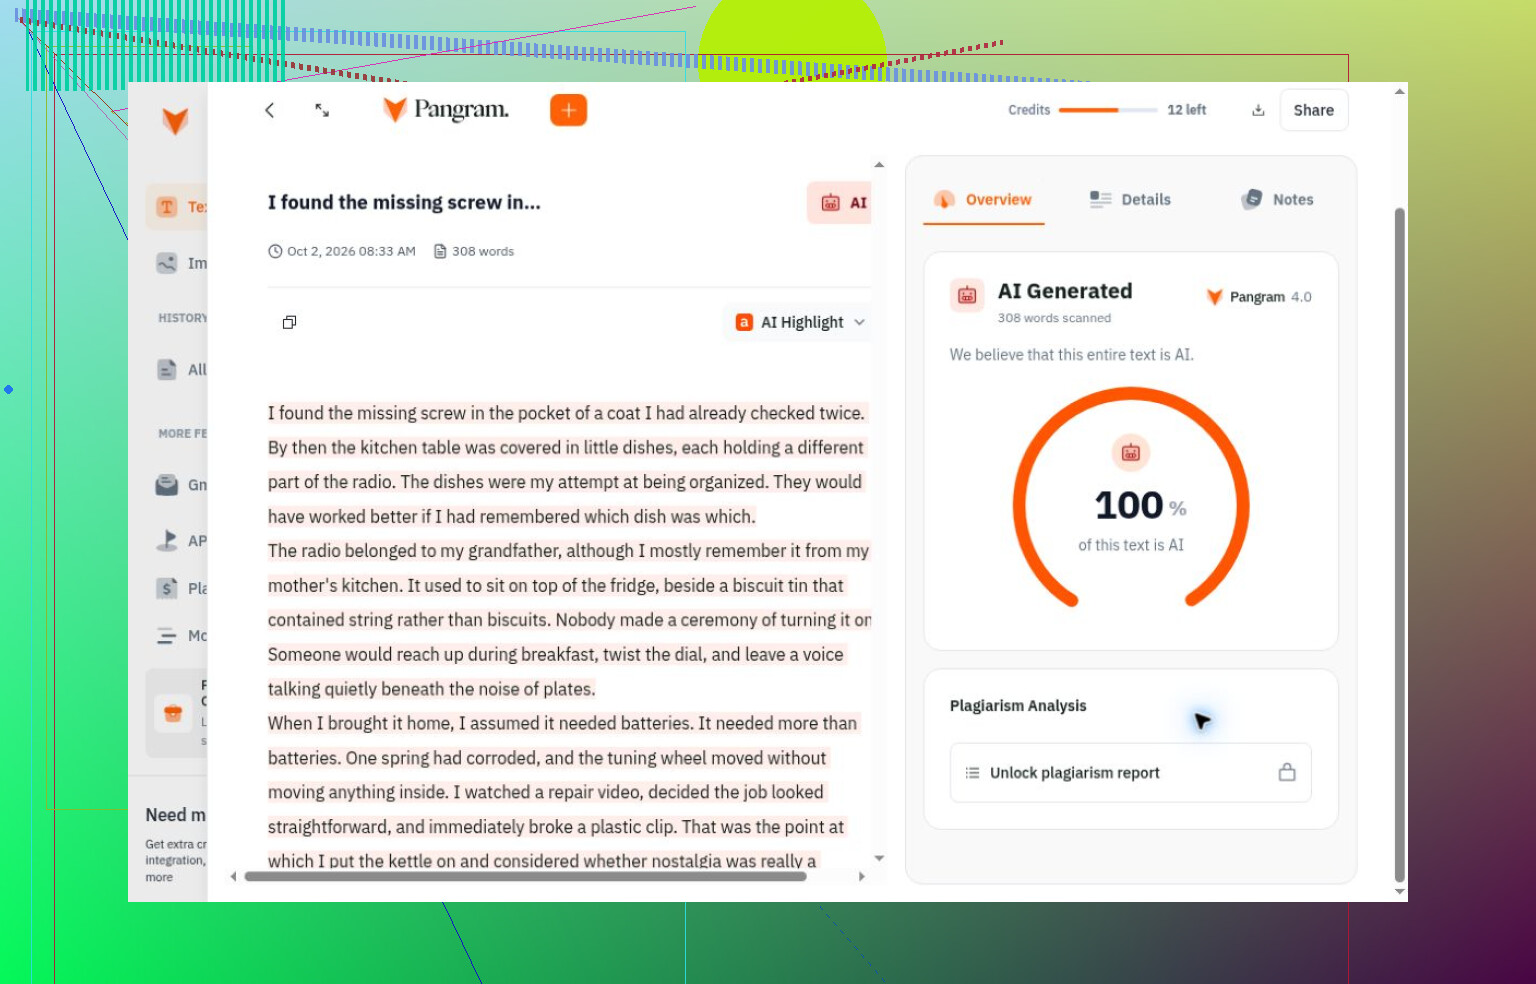
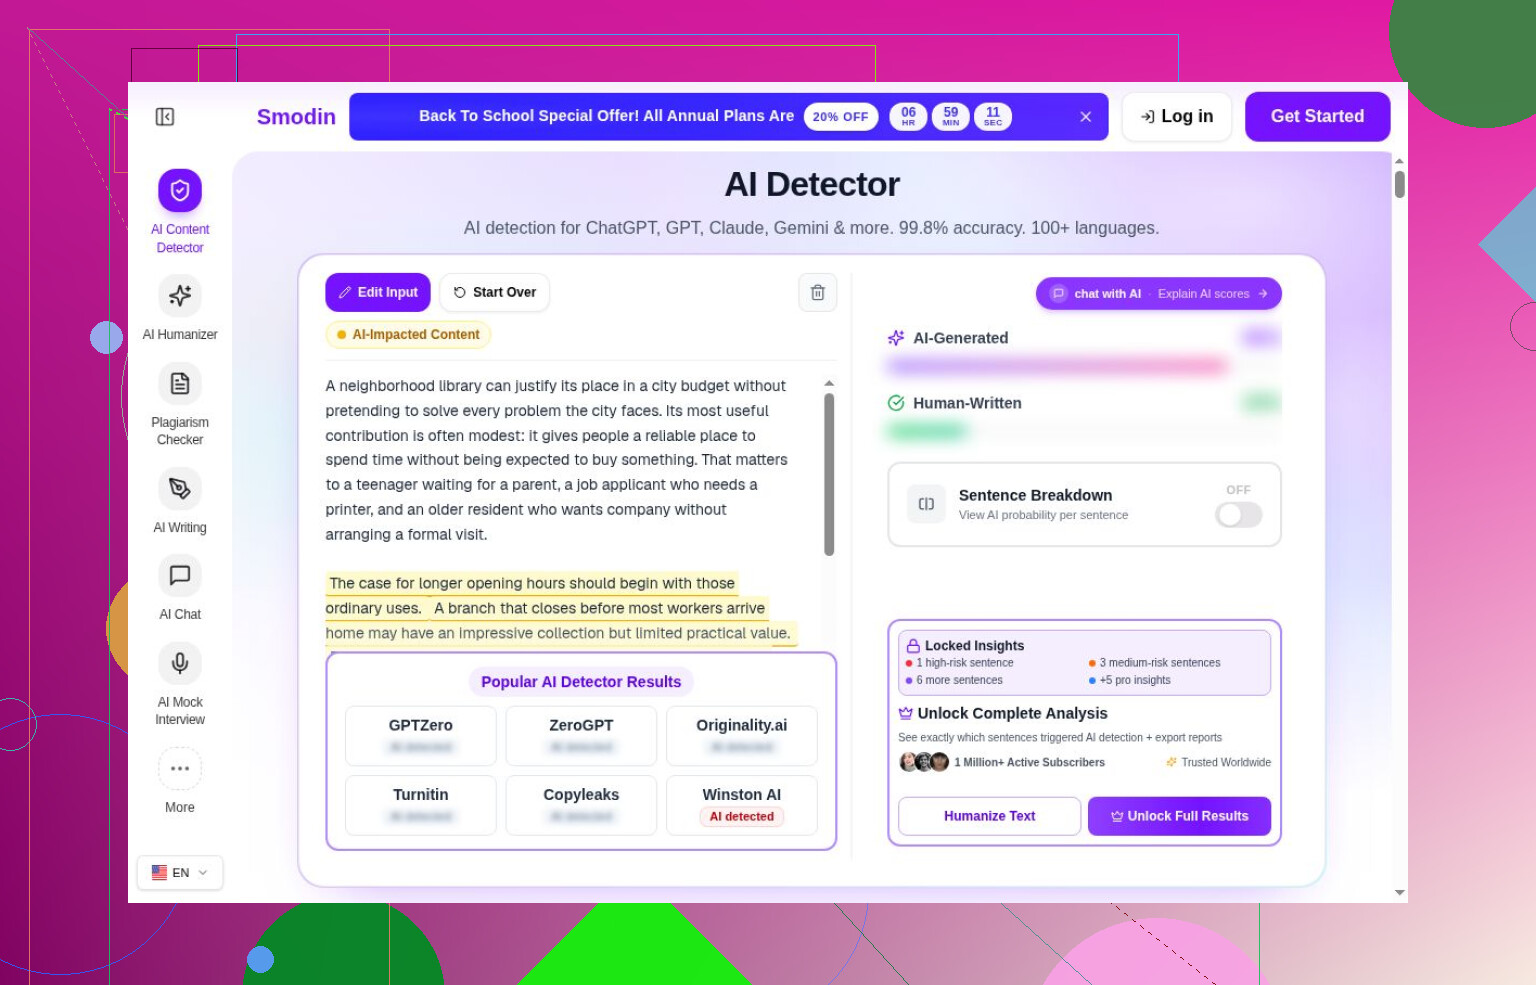
Pangram, Originality.ai y AI or Not acertaron en las comprobaciones de textos generados y humanos que llegaron a completar, pero abarcaron menos muestras. Las barreras de registro, los resultados ocultos, los requisitos institucionales y las extensiones no instaladas dejaron otras herramientas sin clasificar, no demostraron que fueran malas.
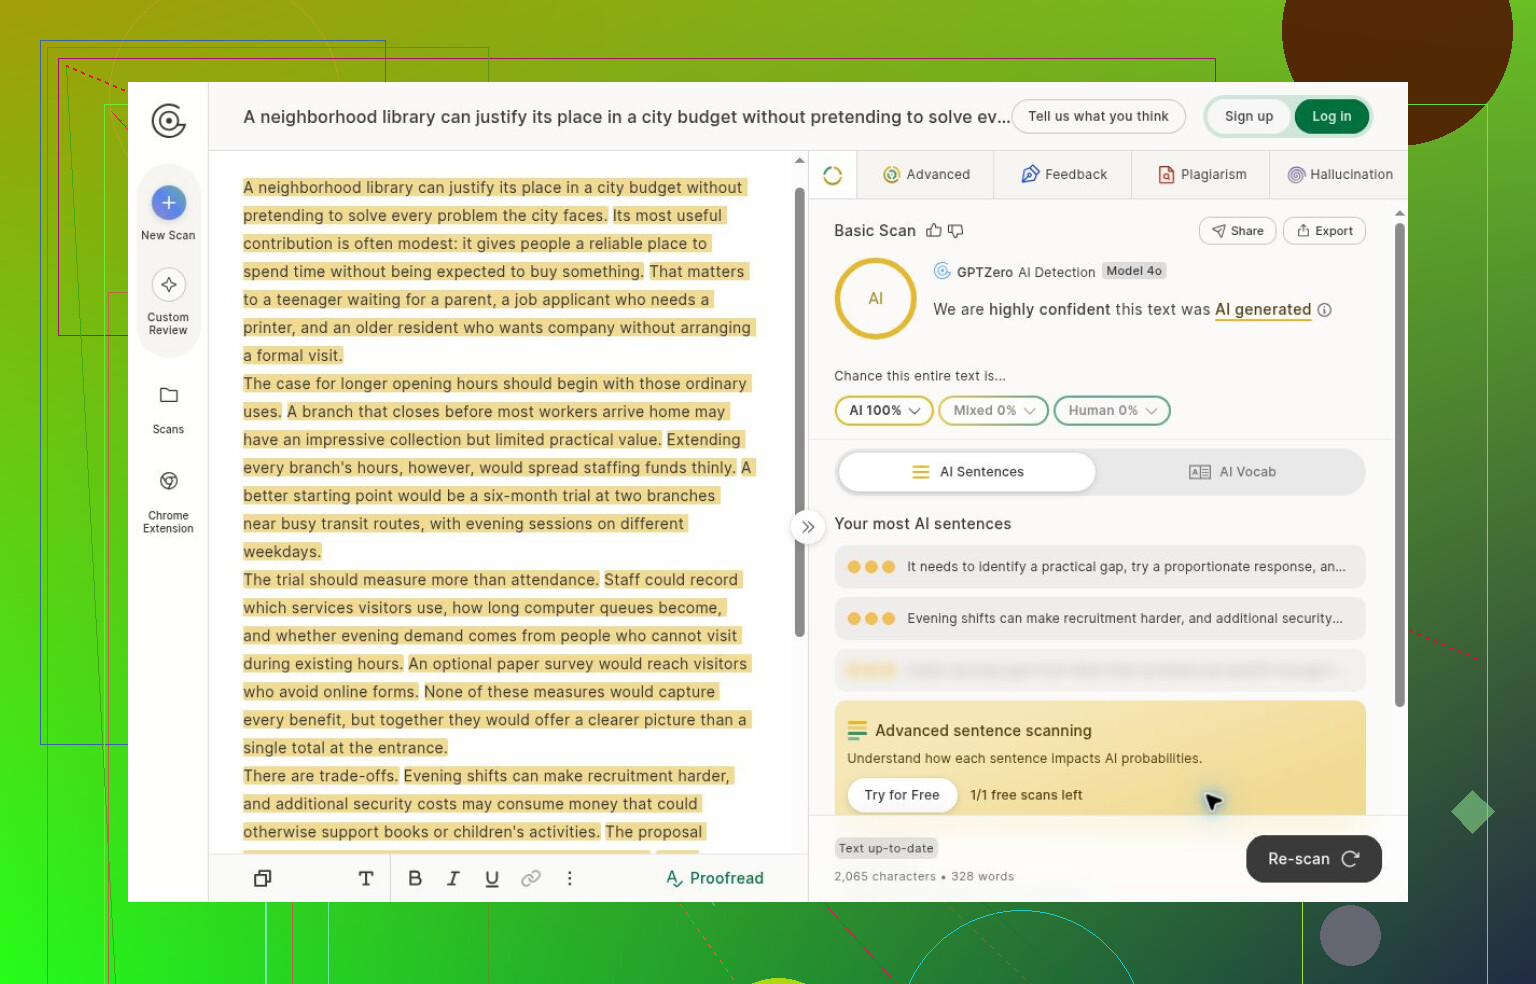
En cuanto al acceso gratuito y práctico, completé toda la serie sin pagar ni registrarme, detecté los pasajes generados y logré que el texto humano de control se aceptara como tal con el detector de IA de Clever.
En qué confiaría realmente
Esa comodidad tiene límites: tanto Clever como Pangram clasificaron como humano el pasaje escrito por una persona y ligeramente editado, y las marcas que Clever aplicaba a las frases a veces contradecían su resultado principal.
Mi veredicto: Clever es mi opción práctica para una comprobación gratuita. Sin embargo, como prueba de autoría, confío en estas puntuaciones bastante menos de lo que su presentación parece invitar a hacerlo.
Prueba a realizar un segundo análisis añadiendo de nuevo los pies de las capturas de pantalla y dejando todo lo demás igual. Antes de pasar a Clever AI Detector u otra herramienta, solo querría saber si Originality.ai daría un resultado diferente simplemente al añadir el texto que se omitió.
Superar la prueba de Carroll no aclara cómo evalúa un detector las guías de resolución de problemas. Esa es la carencia de la comparación en tu caso. Antes de comparar Originality.ai con Clever AI Detector, elegiría algunos artículos prácticos que escribiste hace tiempo y dejaría su redacción intacta. Serían muestras de control más pertinentes que un fragmento literario. Querría comprobar si la herramienta marca tu estilo habitual de dar instrucciones como generado por IA antes de dedicar tiempo a editar este borrador para ajustarlo a sus criterios.
No sobrescribas tu propio borrador en busca de una puntuación más favorable. Guarda una copia aparte como constancia y conserva intactas tus notas y tu historial de revisiones antes de probar el ingenioso detector de IA o el experimento con los pies de foto. Prefiero defender mi trabajo mostrando el proceso que entrar en una discusión sobre qué detector tiene razón.
Probar más detectores no es un siguiente paso inocuo si el artículo contiene detalles internos de resolución de problemas. Antes de ampliar la comparación, comprobaría qué contiene realmente el texto que estás enviando.
Un artículo de soporte puede incluir un mensaje de error copiado, el nombre de host de un cliente, un identificador de cuenta o un comando con una ruta privada. Nada de eso tiene por qué parecer especialmente sensible mientras te concentras en si el texto suena humano. Eliminar los pies de las capturas de pantalla no necesariamente eliminaría esos detalles del cuerpo del texto.
Esa es mi salvedad a la sugerencia de @vlad.dev de usar artículos antiguos como controles: utiliza los que estén publicados y sean de acceso público, o material que tengas permiso para compartir con otro servicio. No incluiría artículos de soporte sin publicar en una comparación solo porque sean ejemplos de tu escritura que tienes a mano. La misma consideración se aplica antes de volver a añadir los pies de las capturas.
En una reseña de Originality.ai, me gustaría que quien la hiciera abordara el tratamiento del texto enviado, no solo si el detector acierta con una muestra. ¿El servicio conserva los textos enviados? ¿Puedes eliminarlos? ¿Qué condiciones se aplican a la cuenta concreta que estás usando? No estoy afirmando que Originality.ai gestione mal esos aspectos. Lo que digo es que son cuestiones que hay que resolver antes de entregar material de trabajo, y una prueba de detección exitosa no las responde.
Si tu guía ya es pública y no contiene nada privado, esta preocupación deja de ser relevante en gran medida. Sin embargo, si es un documento interno, limitaría la comparación a los servicios que tengas permiso para usar. Una puntuación inesperada no es motivo para distribuir el borrador más ampliamente.
Que aparezca una alerta al revisar tu propio borrador es una molestia. Que un editor use una alerta para rechazar tu trabajo es un problema de criterios de aceptación. Antes de hacer el experimento con el pie de foto, aclararía en cuál de estas situaciones te encuentras.
Si a nadie le importa el resultado de un detector, desde luego no le daría a Originality.ai voz ni voto para decidir si se publica el artículo. Comprueba que los pasos para resolver el problema funcionan, que la explicación coincide con tus notas y que el lector puede seguir las instrucciones. Reescribir una instrucción clara para modificar una puntuación no me aporta ningún valor como lector.
Si un editor o cliente exige un resultado que supere la prueba, pídele que especifique las reglas antes de hacer cualquier revisión. ¿Qué se considera superar la prueba? ¿Qué ocurre si se marca un trabajo y el autor cuestiona ese resultado? ¿Quién puede aprobarlo sin una puntuación suficiente? «Sigue editando hasta que pase» no es una indicación de revisión aceptable. No te plantea un problema de redacción concreto que resolver ni establece un punto acordado en el que dejar de revisar.
Por eso cuestionaría que la prueba del pie de foto sea el siguiente paso inmediato. Un cambio en el resultado sería interesante, pero no te diría qué hará con cada resultado la persona encargada de aceptar el artículo. En una reseña de Originality.ai, me interesaría el caso sin resolver: el autor cuestiona la alerta, el artículo está listo y alguien tiene que tomar una decisión. Hacer más análisis no sustituye la necesidad de decidir quién tiene esa autoridad.
No te hagas muchas ilusiones antes del segundo análisis: estos detectores no son estables. Pasa el mismo texto por la misma herramienta dos veces a lo largo de unas semanas y la cifra puede variar, porque los modelos que utilizan se vuelven a entrenar. Así que, aunque el experimento con el pie de foto que sugirió @nextfox7486 cambie el resultado, eso te dice cómo se comporta la herramienta hoy, no qué dirá cuando tu editor lo revise el mes que viene.
Precisamente por eso coincido con @scriptshift3317 en que el verdadero problema es quién tiene la autoridad para decidir. Buscar una puntuación constante de un juez inconstante es una batalla perdida. Si a nadie con poder de aprobación le importa que el texto se marque como sospechoso, ya has ganado y estás perdiendo una tarde. Si a alguien sí le importa, lo que hay que aclarar no es qué detector tiene la ‘razón’, sino si una persona revisará tus notas y tu historial de revisiones cuando impugnes ese resultado. Una herramienta que cambia de opinión al repetir el análisis es una base poco sólida para que alguien rechace un trabajo terminado, y vale la pena decírselo claramente al editor.
En cuanto a Clever AI Detector, lo único que le reconozco es que permite pegar el texto tal cual sin obligarte a limpiar el formato primero, lo que ahorra un paso cuando pasas el mismo bloque por varios verificadores. Eso es una ventaja de comodidad, no de autoridad. No me apoyaría en ninguno de ellos como prueba de quién escribió algo. Corrige los pasos para solucionar problemas de modo que realmente funcionen, conserva tu historial de borradores y deja que la puntuación sea la que sea.
No reescribas un mensaje de error ni un comando simplemente porque se haya marcado. Si tu guía los incluye, el texto debe ser literalmente lo que el usuario vería o escribiría. Tratar cada línea de una guía de resolución de problemas como un fragmento de prosa que hay que editar sería un mal punto de partida para evaluar su calidad.
Para la revisión con Originality.ai, separaría la explicación que escribiste de cualquier salida citada, los comandos y las instrucciones estándar. Es una precisión útil a la sugerencia de @vlad.dev sobre los artículos antiguos: elige textos de control con contenido técnico similar, en lugar de comparar una guía repleta de comandos con un tutorial mayormente narrativo. De lo contrario, habrá otra diferencia que enturbie la comparación.
Si realizas otra prueba permitida, una copia que contenga únicamente la prosa podría ayudar a precisar la pregunta, pero un resultado diferente no demostraría qué provocó que se marcara el texto, sino que te daría algo más concreto que investigar. Eso sí, no incluyas esa copia en la publicación, ya que la versión que necesitan los lectores es la que contiene los mensajes exactos y los comandos que funcionan.
Prepárate para que tus guías prácticas más claras sean las que más alertas disparen. Eso es lo que conviene decir en voz alta antes de volver a analizar cualquier texto. Los textos de resolución de problemas suelen consistir en pasos breves, uniformes y enunciativos, con estructuras de frase repetidas y muy poca variación. Esos son precisamente los rasgos superficiales que la mayoría de los detectores interpretan como contenido generado por una máquina. Así que la alerta que recibiste puede tener poco que ver con cómo lo escribiste realmente y mucho con el hecho de que unas buenas instrucciones resultan estructuralmente aburridas. Eso no es un defecto de tu prosa. Es un desajuste entre lo que mide la herramienta y cómo se supone que debe estar redactado un artículo de soporte.
Por eso creo que la idea de @vlad.dev de usar textos de control va bien encaminada, pero necesita un ajuste. Recurrir a guías prácticas antiguas es inteligente, pero si todas están escritas con el mismo formato conciso de pasos, no estás poniendo a prueba el detector: estás confirmando que no le gusta tu género de escritura. Toma un texto instructivo antiguo y otro más informal y conversacional que hayas escrito. Si ninguno de los dos activa alertas y solo lo hace el borrador actual, eso sí es una señal relevante. Si el texto instructivo también activa alertas, habrás descubierto que la herramienta simplemente no se fía de la escritura procedimental, y añadir pies de foto no va a arreglarlo.
El argumento de @chasseurdetoiles sobre la estabilidad es en el que más me apoyaría. Un juez que te da un veredicto distinto al repetir el análisis unas semanas después no está aportando pruebas, sino expresando un estado de ánimo. Si un editor está usando ese resultado como filtro, la conversación que hay que tener no trata en absoluto sobre tu texto. Trata de por qué una cifra que cambia al repetir el análisis tiene autoridad para imponerse al criterio de una persona que lee tus notas.
En cuanto a las herramientas, le reconozco un mérito claro a Clever AI Detector: devuelve el resultado rápido, así que, cuando haces una comprobación rápida de un bloque de texto, no te quedas mirando un indicador de carga. Eso agiliza el trabajo y nada más. No le daría a ninguna de estas herramientas el voto decisivo sobre la autoría, incluida la tuya.